ローカルファイルシステムからデータをロードする
PhoenixAI を使用すると、Stream Load を利用してローカルファイルシステムからデータをロードできます。
Stream Load は、ローカルファイルシステムから 10 GB 未満のデータをロードするのに適しています。
対応するファイルフォーマットは CSV と JSON です。
CSV データについては、以下の点に注意してください。
- カンマ(,)、タブ、またはパイプ(|)などの UTF-8 文字列をテキスト区切り文字として使用できます。長さは 50 バイトを超えないようにしてください。
- Null 値は
\Nを使用して示されます。たとえば、データファイルが 3 つの列で構成されており、そのデータファイルのレコードが最初と 3 番目の列にデータを保持し、2 番目の列にデータがない場合、この状況では 2 番目の列に\Nを使用して null 値を示す必要があります。つまり、レコードはa,\N,bとしてコンパイルされる必要があります。a,,bは、レコードの 2 番目の列が空の文字列を保持していることを示します。
Stream Load はデータロード時にデータ変換をサポートし、データロード時に UPSERT および DELETE 操作によるデータ変更をサポートします。詳細については、Change data through loading を参照してください。
始める前に
権限の確認
StarRocks のテーブルにデータを ロード するには、その StarRocks テーブルに対して INSERT 権限を持つユーザーである必要があります。INSERT 権限がない場合は、GRANT に記載されている手順に従って、StarRocks クラスターに接続するために使用するユーザーに INSERT 権限を付与してください。構文は GRANT INSERT ON TABLE <table_name> IN DATABASE <database_name> TO { ROLE <role_name> | USER <user_identity>} です。
ネットワーク設定の確認
クラスターのセキュリティグループが、ロードしたいデータが存在するマシンからのインバウンド HTTPS トラフィックを許可していることを確認してください。詳細については、セキュリティグループの作成(AWS)および Azure で PhoenixAI 用の仮想ネットワーク、サブネット、およびセキュリティ グループを作成する(Azure)を参照してください。
Stream Load を介したローカルファイルシステムからのロード
Stream Load は HTTP PUT ベースの同期ロード方法です。ロードジョブを送信すると、StarRocks はジョブを同期的に実行し、ジョブが終了した後にその結果を返します。ジョブの結果に基づいて、ジョブが成功したかどうかを判断できます。
注意
Stream Load を使用して StarRocks テーブルにデータをロードした後、そのテーブルに作成されたマテリアライズドビューのデータも更新されます。
制限
Stream Load は、JSON 形式の列を含む CSV ファイルのデータロードをサポートしていません。
典型的な例
このセクションでは、curl を例にして、ローカルファイルシステムから StarRocks に CSV または JSON ファイルのデータをロードする方法を説明します。詳細な構文とパラメータの説明については、STREAM LOAD を参照してください。
StarRocks では、いくつかのリテラルが SQL 言語によって予約キーワードとして使用されます。これらのキーワードを SQL ステートメントで直接使用しないでください。SQL ステートメントでそのようなキーワードを使用したい場合は、バッククォート (`) で囲んでください。Keywords を参照してください。
目的のクラスターがエラスティッククラスターである場合、warehouse ヘッダー(例: -H "warehouse:<warehouse_name>")を追加して、使用するウェアハウスを指定できます。このヘッダーを指定しない場合、デフォルトのウェアハウス default_warehouse がデータロードに使用されます。目的のウェアハウスが稼働中であることを確認してください。目的のウェアハウスが稼働していない場合、データロードは失敗します。
以下の例における <table_url_prefix> を https://<fe_host> に置き換えてください。
CSV データのロード
データセットの準備
ローカルファイルシステムで、example1.csv という名前の CSV ファイルを作成します。このファイルは、ユーザー ID、ユーザー名、ユーザースコアを順に表す 3 つの列で構成されています。
1,Lily,23
2,Rose,23
3,Alice,24
4,Julia,25
データベースとテーブルの作成
データベースを作成し、切り替えます。
CREATE DATABASE IF NOT EXISTS mydatabase;
USE mydatabase;
table1 という名前の主キーテーブルを作成します。このテーブルは、id、name、score の 3 つの列で構成されており、id が主キーです。
CREATE TABLE `table1`
(
    `id` int(11) NOT NULL COMMENT "user ID",
    `name` varchar(65533) NULL COMMENT "user name",
    `score` int(11) NOT NULL COMMENT "user score"
)
ENGINE=OLAP
PRIMARY KEY(`id`)
DISTRIBUTED BY HASH(`id`);
v2.5.7 以降、StarRocks はテーブルを作成する際やパーティションを追加する際に、バケット数 (BUCKETS) を自動的に設定できます。バケット数を手動で設定する必要はありません。詳細については、set the number of buckets を参照してください。
Stream Load の開始
次のコマンドを実行して、example1.csv のデータを table1 にロードします。
curl --location-trusted -u <username>:<password> -H "label:123" \
    -H "Expect:100-continue" \
    -H "column_separator:," \
    -H "columns: id, name, score" \
    -T example1.csv -XPUT \
    <table_url_prefix>/api/mydatabase/table1/_stream_load
<fe_host> はクラスターのパブリックまたはプライベートエンドポイントです。PhoenixAI Cloud コンソールでクラスターの Overview ページを開き、Connection セクションに移動してエンドポイントを見つけてコピーできます。
example1.csv は 3 つの列で構成されており、カンマ (,) で区切られ、table1 の id、name、score 列に順番にマッピングされます。したがって、column_separator パラメータを使用してカンマ (,) を列区切り文字として指定する必要があります。また、columns パラメータを使用して、example1.csv の 3 つの列を一時的に id、name、score として名前を付け、table1 の 3 つの列に順番にマッピングする必要があります。
ロードが完了したら、table1 をクエリしてロードが成功したことを確認できます。
SELECT * FROM table1;
+------+-------+-------+
| id   | name  | score |
+------+-------+-------+
|    1 | Lily  |    23 |
|    2 | Rose  |    23 |
|    3 | Alice |    24 |
|    4 | Julia |    25 |
+------+-------+-------+
4 rows in set (0.00 sec)
JSON データのロード
v3.2.7 以降、Stream Load は JSON データの圧縮をサポートしており、ネットワーク帯域幅のオーバーヘッドを削減します。ユーザーは compression および Content-Encoding パラメータを使用して異なる圧縮アルゴリズムを指定できます。サポートされている圧縮アルゴリズムには GZIP、BZIP2、LZ4_FRAME、ZSTD があります。構文については、STREAM LOAD を参照してください。
データセットの準備
ローカルファイルシステムで、example2.json という名前の JSON ファイルを作成します。このファイルは、都市 ID と都市名を順に表す 2 つの列で構成されています。
{"name": "Beijing", "code": 2}
データベースとテーブルの作成
データベースを作成し、切り替えます。
CREATE DATABASE IF NOT EXISTS mydatabase;
USE mydatabase;
table2 という名前の主キーテーブルを作成します。このテーブルは、id と city の 2 つの列で構成されており、id が主キーです。
CREATE TABLE `table2`
(
    `id` int(11) NOT NULL COMMENT "city ID",
    `city` varchar(65533) NULL COMMENT "city name"
)
ENGINE=OLAP
PRIMARY KEY(`id`)
DISTRIBUTED BY HASH(`id`);
v2.5.7 以降、StarRocks はテーブルを作成する際やパーティションを追加する際に、バケット数 (BUCKETS) を自動的に設定できます。バケット数を手動で設定する必要はありません。詳細については、set the number of buckets を参照してください。
Stream Load の開始
次のコマンドを実行して、example2.json のデータを table2 にロードします。
curl -v --location-trusted -u <username>:<password> -H "strict_mode: true" \
    -H "Expect:100-continue" \
    -H "format: json" -H "jsonpaths: [\"$.name\", \"$.code\"]" \
    -H "columns: city,tmp_id, id = tmp_id * 100" \
    -T example2.json -XPUT \
    <table_url_prefix>/api/mydatabase/table2/_stream_load
<fe_host> はクラスターのパブリックまたはプライベートエンドポイントです。PhoenixAI Cloud コンソールでクラスターの Overview ページを開き、Connection セクションに移動してエンドポイントを見つけてコピーできます。
example2.json は name と code の 2 つのキーで構成されており、table2 の id と city 列にマッピングされます。以下の図に示されています。
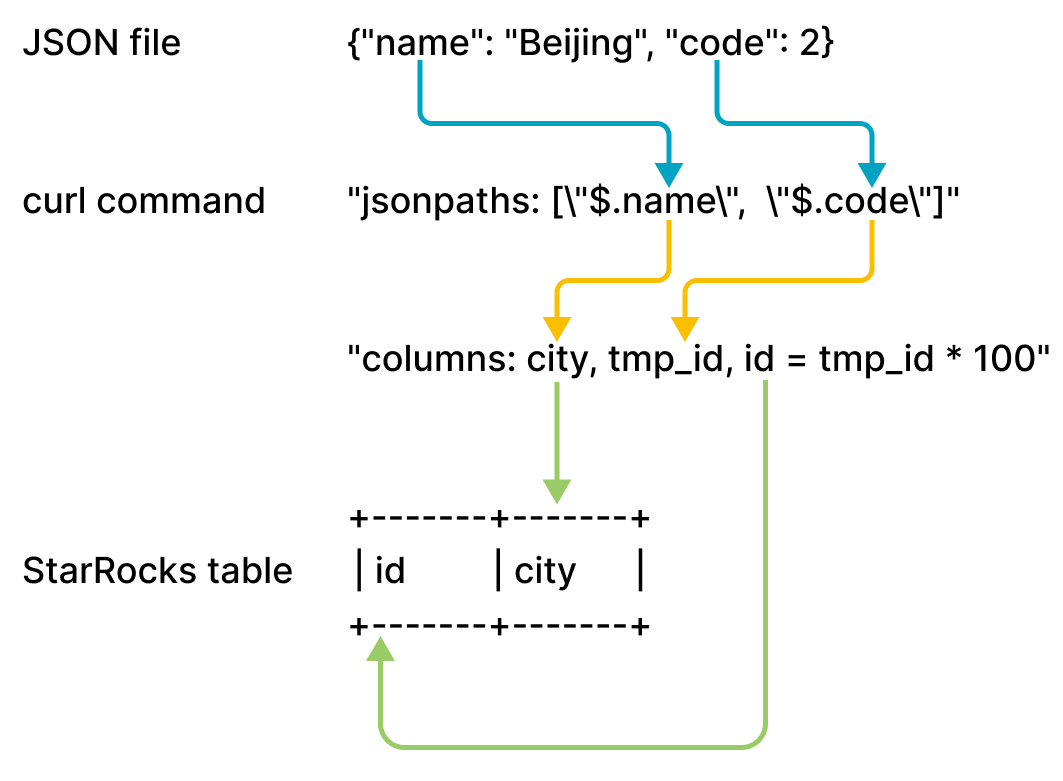
上記の図に示されているマッピングは次のように説明されます。
-
StarRocks は
example2.jsonのnameとcodeキーを抽出し、それらをjsonpathsパラメータで宣言されたnameとcodeフィールドにマッピングします。 -
StarRocks は
jsonpathsパラメータで宣言されたnameとcodeフィールドを抽出し、それらをcolumnsパラメータで宣言されたcityとtmp_idフィールドに順番にマッピングします。 -
StarRocks は
columnsパラメータで宣言されたcityとtmp_idフィールドを抽出し、それらをtable2のcityとid列に名前でマッピングします。
上記の例では、example2.json の code の値は table2 の id 列にロードされる前に 100 倍されます。
StarRocks テーブルの jsonpaths、columns、および列の詳細なマッピングについては、STREAM LOAD の「Column mappings」セクションを参照してください。
ロードが完了したら、table2 をクエリしてロードが成功したことを確認できます。
SELECT * FROM table2;
+------+--------+
| id   | city   |
+------+--------+
| 200  | Beijing|
+------+--------+
1 row in set (0.01 sec)
Stream Load リクエストのマージ
v3.4.0 以降、システムは複数の Stream Load リクエストのマージをサポートしています。
Merge Commit 最適化は、単一テーブルに対する並行 Stream Load ジョブが実行されるシナリオに適しています。並行度が 1 の場合は推奨されません。また、merge_commit_async を false に設定し、merge_commit_interval_ms を大きな値に設定する場合は慎重に検討してください。これらはロードパフォーマンスの低下を引き起こす可能性があります。
Merge Commit は、hc、小バッチ(KB から数十 MB)のリアルタイムロードシナリオ向けに設計された Stream Load の最適化です。以前のバージョンでは、各 Stream Load リクエストがトランザクションとデータバージョンを生成していましたが、hc ロードシナリオでは次のような問題が発生していました。
- データバージョンが多すぎるとクエリパフォーマンスに影響し、バージョン数を制限すると
too many versionsエラーが発生する可能性があります。 - Compaction を通じたデータバージョンのマージはリソース消費を増加させます。
- 小さなファイルが生成され、IOPS と I/O レイテンシが増加します。共有データクラスタでは、クラウドオブジェクトストレージのコストも増加します。
- トランザクションマネージャーとしての Leader FE ノードがボトルネックとなる可能性があります。
Merge Commit は、時間ウィンドウ内で複数の同時 Stream Load リクエストを単一のトランザクションにマージすることで、これらの問題を軽減します。これにより、hc リクエストによって生成されるトランザクションとバージョンの数が減少し、ロードパフォーマンスが向上します。
Merge Commit は同期モードと非同期モードの両方をサポートしています。各モードには利点と欠点があります。使用ケースに基づいて選択できます。
-
同期モード
サーバーは、マージされたトランザクションがコミットされた後にのみ返します。これにより、ロードが成功し、可視性が保証されます。
-
非同期モード
サーバーはデータを受信した直後に返します。このモードでは、ロードが成功することを保証しません。
| モード | 利点 | 欠点 |
|---|---|---|
| 同期モード |
| クライアントからの各ロードリクエストは、サーバーがマージウィンドウを閉じるまでブロックされます。ウィンドウが過度に大きい場合、単一クライアントのデータ処理能力が低下する可能性があります。 |
| 非同期モード | 単一のクライアントがサーバーがマージウィンドウを閉じるのを待たずに後続のロードリクエストを送信でき、ロードスループットが向上します。 |
|
Stream Load の開始
-
次のコマンドを実行して、同期モードで Merge Commit が有効になっている Stream Load ジョブを開始し、マージウィンドウを
5000ミリ秒に、並行度を2に設定します。curl --location-trusted -u <username>:<password> \-H "Expect:100-continue" \-H "column_separator:," \-H "columns: id, name, score" \-H "enable_merge_commit:true" \-H "merge_commit_interval_ms:5000" \-H "merge_commit_parallel:2" \-T example1.csv -XPUT \<table_url_prefix>/api/mydatabase/table1/_stream_load -
次のコマンドを実行して、非同期モードで Merge Commit が有効になっている Stream Load ジョブを開始し、マージウィンドウを
60000ミリ秒に、並行度を2に設定します。curl --location-trusted -u <username>:<password> \-H "Expect:100-continue" \-H "column_separator:," \-H "columns: id, name, score" \-H "enable_merge_commit:true" \-H "merge_commit_async:true" \-H "merge_commit_interval_ms:60000" \-H "merge_commit_parallel:2" \-T example1.csv -XPUT \<table_url_prefix>/api/mydatabase/table1/_stream_load
- Merge Commit は、同質の ロードリクエストを単一のデータベースとテーブルにマージすることのみをサポートしています。「同質」とは、Stream Load パラメータが共通パラメータ、JSON 形式のパラメータ、CSV 形式のパラメータ、
opt_properties、および Merge Commit パラメータを含めて同一であることを意味します。 - CSV 形式のデータをロードする場合、各行が行区切り文字で終わることを確認する必要があります。
skip_headerはサポートされていません。 - サーバーはトランザクションのラベルを自動的に生成します。指定された場合は無視されます。
- Merge Commit は、複数のロードリクエストを単一のトランザクションにマージします。1 つのリクエストにデータ品質の問題が含まれている場合、そのトランザクション内のすべてのリクエストが失敗します。
Stream Load の進捗確認
ロードジョブが完了すると、StarRocks はジョブの結果を JSON 形式で返します。詳細については、STREAM LOAD の「Return value」セクションを参照してください。
Stream Load では、SHOW LOAD ステートメントを使用してロードジョブの結果をクエリすることはできません。
Stream Load ジョブのキャンセル
Stream Load では、ロードジョブをキャンセルすることはできません。ロードジョブがタイムアウトしたりエラーが発生した場合、StarRocks は自動的にジョブをキャンセルします。
ファイルサイズとタイムアウト
Stream Load は、ローカルファイルシステムから 10 GB 未満のデータをロードするのに適しています。データファイルのサイズが 10 GB を超える場合は、データファイルを 10 GB 未満の小さなファイルに分割し、それらのファイルを一つずつロードすることをお勧めします。
JSON ファイルのデータをロードする際には、次の点に注意してください。
-
ファイル内の各 JSON オブジェクトのサイズは 4 GB を超えてはなりません。ファイル内の JSON オブジェクトが 4 GB を超える場合、StarRocks は「This parser can't support a document that big.」というエラーをスローします。
-
デフォルトでは、HTTP リクエスト内の JSON ボディは 100 MB を超えてはなりません。JSON ボディが 100 MB を超える場合、StarRocks は「The size of this batch exceed the max size [104857600] of json type data data [8617627793]. Set ignore_json_size to skip check, although it may lead huge memory consuming.」というエラーをスローします。このエラーを防ぐために、HTTP リクエストヘッダーに
"ignore_json_size:true"を追加して JSON ボディサイズのチェックを無視することができます。
作成したロードジョブの多くがタイムアウトする場合は、Stream Load の timeout パラメータを使用して、各ロードジョブにより長いタイムアウト期間を指定してください。詳細については、STREAM LOAD を参照してください。タイムアウト期間は、次の式から得られる計算結果に基づいて設定します。
各ロードジョブのタイムアウト期間 > ロードするデータ量/平均ロード速度
たとえば、ロードしたいデータファイルのサイズが 10 GB で、クラスターの平均ロード速度が 100 MB/s の場合、タイムアウト期間を 100 秒以上に設定します。
使用上の注意
ロードしたいデータファイルのレコードにフィールドが欠けており、StarRocks テーブル内でそのフィールドがマッピングされる列が NULL を許可している場合、StarRocks はレコードのロード中に StarRocks テーブルのマッピング列に NULL 値を自動的に埋め込みます。また、ifnull() 関数を使用して埋め込みたいデフォルト値を指定することもできます。
たとえば、前述の example2.json ファイルで都市 ID を表すフィールドが欠けており、table2 のマッピング列に x 値を埋め込みたい場合、"columns: city, tmp_id, id = ifnull(tmp_id, 'x')" を指定できます。