Compute Replica
Compute Replica は、ウェアハウスのローカルキャッシュの冗長コピーを複数の Compute Node (CN) に保持します。これにより、ノードの再起動、スケーリング、ローリングアップグレード、ネットワーク上での到達不能が発生しても、クエリレイテンシを予測可能な範囲に保てます。
概要
共有データクラスタでは、データの信頼できる唯一の情報源 (source of truth) はオブジェクトストレージ (Amazon S3、Azure Blob Storage、Google Cloud Storage など) にあり、データの信頼性はオブジェクトストレージサービスによって保証されます。各 Compute Node は、担当するタブレットデータのローカルキャッシュを保持するため、クエリのたびにオブジェクトストレージから読み取る必要はありません。
デフォルトでは、各タブレットは1 台の Compute Node にのみキャッシュされます。そのため、パフォーマンスの信頼性に次のような課題が生じます。
- HA イベント時のキャッシュ消失 — CN がクラッシュした場合、メモリ不足になった場合、またはローリングアップグレード中に再起動された場合、その CN のタブレットはキャッシュが空 (コールド) の別の CN に再スケジュールされます。直後のクエリでは大量のキャッシュミスと低速なリモート読み取りが発生し、テールレイテンシが急上昇します。これは、厳しい P99 SLA を持つリアルタイムの顧客向けワークロードにとって特に深刻です。
- スケーリング時のキャッシュ無効化 — スケールアウトやスケールインによってタブレットがノード間で再配置されるため、大量のキャッシュが無効になり、キャッシュが再びウォームアップされるまでクエリパフォーマンスが低下します。
- トラフィックのホットスポット — 特定のタブレットへの同時アクセスが、そのタブレットをキャッシュしている 1 台の CN に集中します。
レイテンシに敏感な顧客向け分析を運用するには、共有データアーキテクチャのコスト面の利点を損なうことなく、こうしたレイテンシの急激な悪化を取り除く必要があります。Compute Replica は、ストレージではなくキャッシュ層を複数の CN に複製することで、この要件に応えます。
Compute Replica は、ノードの入れ替わり、スケーリング、ローリングアップグレードの間もテールレイテンシを予測可能にします。定常状態のクエリを速くするものではありません。その効果は、クラスタに何らかの障害や変動が起きたときにこそ現れます。
リアルタイムの顧客向け分析ワークロードを用いたテストでは、各タブレットを 1 台のノードにのみキャッシュした場合、Compute Node を 1 台再起動しただけで P99 クエリレイテンシが約 3.5 倍に上昇しました。2 つのコンピュートレプリカ、同期キャッシュレプリケーション、インデックスレベルのウォームアップを組み合わせた場合、同じ再起動による P99 レイテンシの上昇は約 20% にとどまり、ワークロードの 1 秒未満の SLA 内に収まりました。
仕組み
Compute Replica は、各タブレットを複数の CN にスケジュールし、それらのノードのキャッシュをウォームな状態に保ちます。あるノードがダウンすると、クエリプランナーはそのノードを避け、タブレットのウォームなコピーをすでに保持している稼働中のノードにクエリをルーティングします。これにより、オブジェクトストレージからのコールドリードを回避できます。
変更前 — 単一レプリカ: ノードに障害が発生すると、そのノードにキャッシュされていたタブレットは失われます。クエリはオブジェクトストレージからの低速なリモート読み取りに頼ることになります。
変更後 — compute_replica = 2: すべてのタブレットが 2 台のノードにキャッシュされます。ノードに障害が発生すると、プランナーはそのノードをスキップし、稼働中のノードがウォームなレプリカキャッシュから該当するタブレットを提供します。
Compute Replica は、次の 3 つの独立した機能を組み合わせたものです。
| 機能 | 内容 | 制御するプロパティ |
|---|---|---|
| 複数のコンピュートレプリカ | 各タブレットを 1 台ではなく N 台の Compute Node にスケジュールし、フェイルオーバー先を確保するとともに、単一タブレットに対する同時実行性を高めます。 | compute_replica |
| キャッシュレプリケーション | 新しいデータが書き込まれると (ロード、コンパクション、DDL)、そのデータを他のレプリカ CN のキャッシュに複製し、複数のノードをウォームな状態に保ちます。 | replication_type |
| キャッシュウォームアップ | タブレットが CN に新たに配置されたとき (スケールアウト後など)、レプリカがトラフィックを処理する前に、CN がオブジェクトストレージからメタデータやデータを先行して取得します。 | warmup_level |
レプリカがクエリから見えるようになるのは、ウォームアップが完了した後だけです。キャッシュレプリケーションが失敗しても、トランザクションのコミットやデータの整合性には影響しません。影響するのは、ピアノードのキャッシュがウォームかどうかだけです。
PhoenixAI Cloud コンソールで Compute Replica を有効にする
Compute Replica は、コンソールからウェアハウスごとに直接設定できます。クラスタが Running 状態であり、cluster_admin ロールが必要です。
1. ウェアハウスを開く
-
PhoenixAI Cloud コンソールにサインインします。
-
Clusters ページで、設定するエラスティッククラスタをクリックします。
-
クラスタの詳細ページで、Warehouses タブをクリックします。
-
設定するウェアハウス (例:
default_warehouse) をクリックします。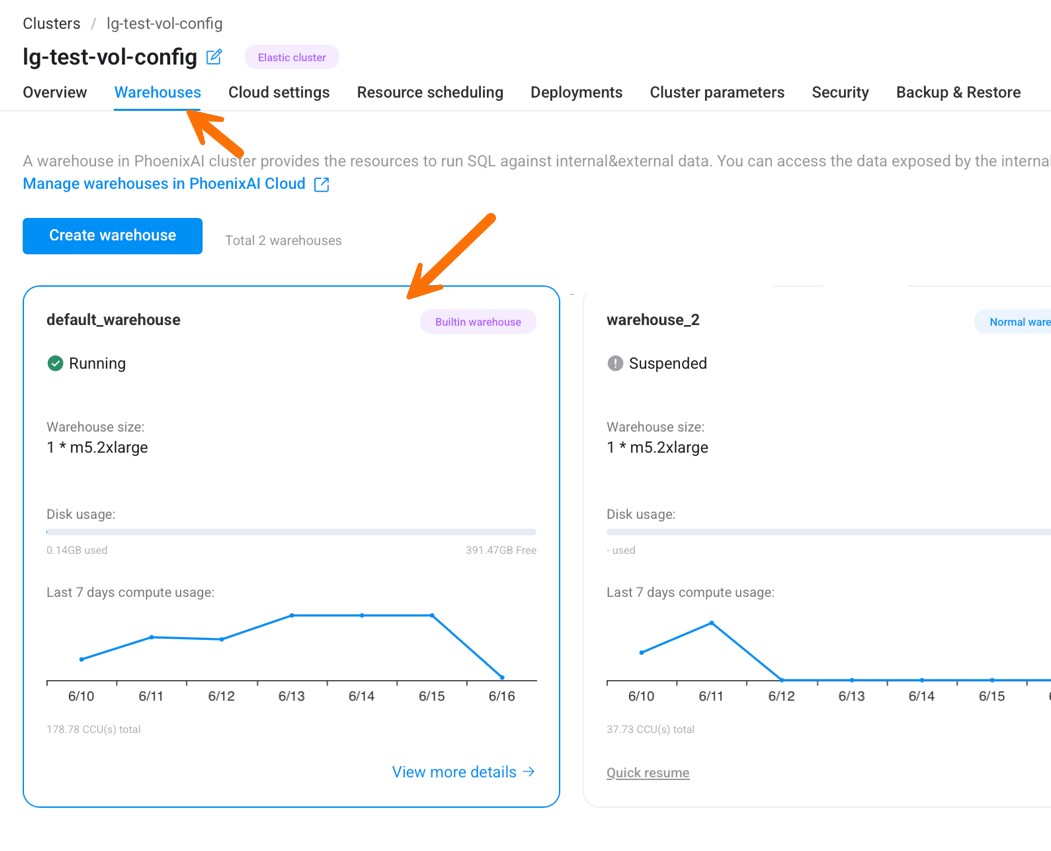
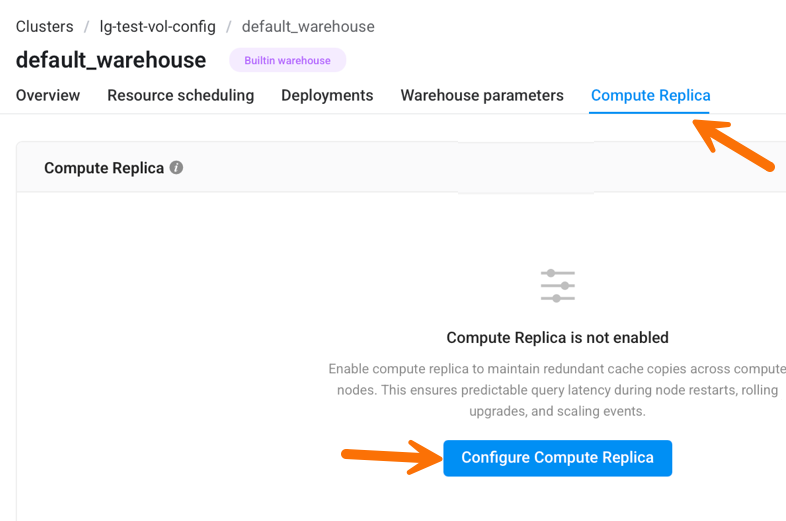
2. Compute Replica タブを開く
ウェアハウスの詳細ページで、Compute Replica タブをクリックします。Compute Replica がまだ有効になっていない場合は、空の状態が表示されます。Configure Compute Replica をクリックします。
3. 設定して有効にする
次のオプションを設定し、Enable Compute Replica をクリックします。
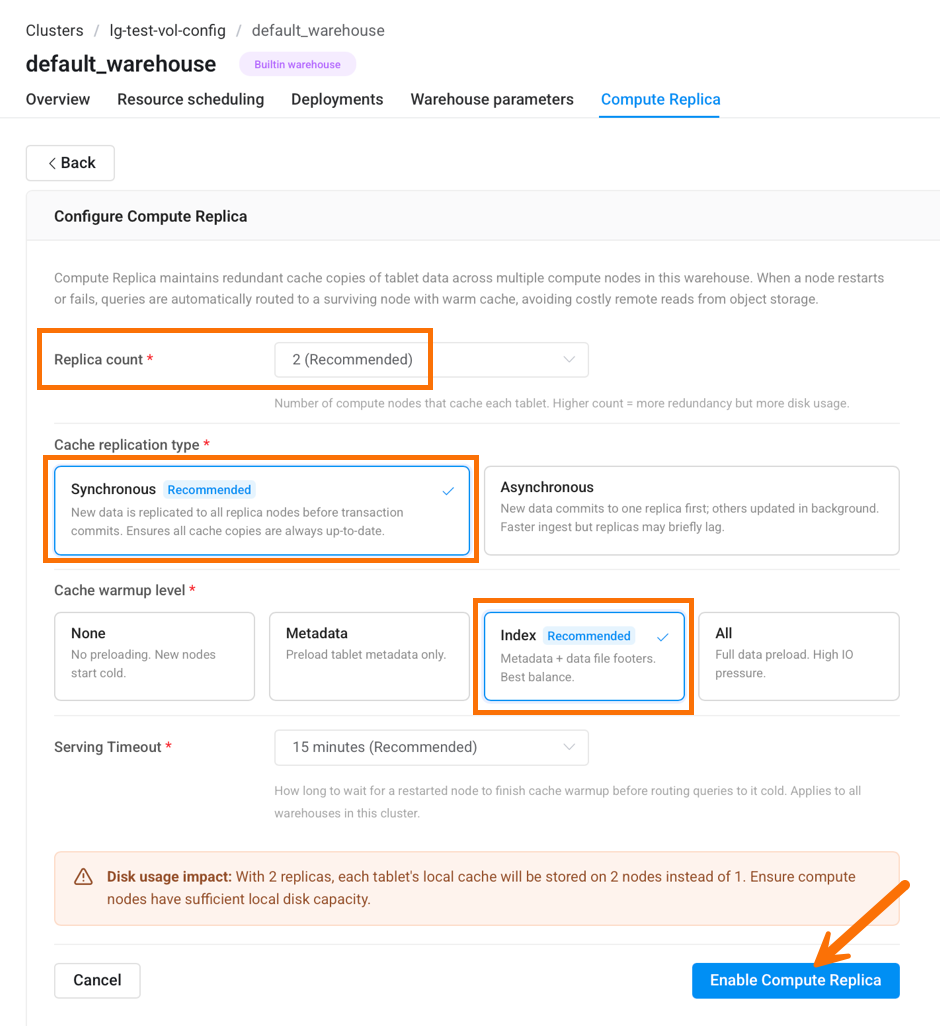
| フィールド | 推奨値 | 説明 |
|---|---|---|
| Replica count | 2 | 各タブレットをキャッシュする Compute Node の数。値を大きくすると冗長性は高まりますが、ローカルディスクの使用量が増えます。 |
| Cache replication type | Synchronous | Synchronous は、トランザクションがコミットされる前に新しいデータをすべてのレプリカノードに複製するため、すべてのキャッシュコピーが常に最新の状態に保たれます。Asynchronous は、まず 1 つのレプリカにコミットし、残りをバックグラウンドで更新します。取り込みは速くなりますが、レプリカが一時的に遅れることがあります。 |
| Cache warmup level | Index | 新たに配置されたノードがサービス開始前にどこまで事前ロードするかを決めます。Index (メタデータとデータファイルのフッター) が推奨されるバランスです。None はコールドな状態で開始し、All はデータファイル全体を事前ロードするため大きな I/O 負荷がかかります。 |
| Serving timeout | 15 分 | 再起動したノードのキャッシュウォームアップの完了を待つ時間。この時間を過ぎると、ウォームアップが終わっていなくてもクエリがそのノードにルーティングされます。この設定はクラスタ内のすべてのウェアハウスに適用されます。特に指示がない限り、推奨値のままにしてください。 |
レプリカ数を 2 にすると、各タブレットのローカルキャッシュは 1 台ではなく 2 台のノードに保存されます。有効にする前に、Compute Node に十分なローカルディスク容量があることを確認してください。
4. 表示、編集、無効化
Compute Replica を有効にすると、Compute Replica タブに現在のレプリカ数、レプリケーションタイプ、ウォームアップレベル、サービングタイムアウトの概要が表示されます。
- Edit をクリックすると、任意の設定を変更できます。変更はウェアハウスを作り直さなくても反映されます。
- Disable をクリックすると、Compute Replica が無効になります。ウェアハウスは、タブレットごとに 1 つのキャッシュコピーを持つ状態に戻ります。
Compute Replica のプロパティ
Compute Replica は、compute_replica、replication_type、warmup_level の 3 つのウェアハウスプロパティで制御します。
PhoenixAI Cloud では、PhoenixAI Cloud コンソールで Compute Replica を有効にするで説明したとおり、これらのプロパティをコンソールで設定します。Replica count は compute_replica を、Cache replication type は replication_type を、Cache warmup level は warmup_level を設定します。現在の値は SHOW WAREHOUSES の Property 列で確認できます。
プロパティリファレンス
compute_replica
- デフォルト:
1 - 説明: コンピュートレプリカの数。各タブレットをキャッシュする Compute Node の数です。
compute_replica の最大値は、FE の動的設定項目 lake_warehouse_max_compute_replica (デフォルト: 3) によって制限されます。
replication_type
- デフォルト:
NONE - 説明: キャッシュレプリケーションのタイプ。CN にデータが書き込まれると、この設定に従って他のレプリカ CN のキャッシュにデータが複製されます。有効な値:
NONE(デフォルト): レプリケーションを行いません。SYNC: 新しいデータをすべてのレプリカ CN に同期的に複製します。ロードトランザクションが成功した時点で、データはすべてのコンピュートレプリカに存在します。ASYNC: トランザクションが成功した時点で、新しいデータは少なくとも 1 つのレプリカにコミットされます。残りのレプリカはバックグラウンドで更新されます。
- レプリケーションのタイムアウトは、CN の動的設定項目
starlet_cache_replication_timeout_ms(デフォルト:5000ミリ秒) で設定します。 - バックグラウンドのレプリケーションスレッド数 (
ASYNCの場合のみ有効) は、CN の動的設定項目starlet_cache_thread_num(デフォルト:16) で設定します。
レプリケーションの失敗は、トランザクションのコミットやデータの整合性には影響しません。 影響するのは、ピアレプリカのキャッシュがウォームかどうかだけです。主な原因は、ネットワークやディスク I/O によるレプリケーションのタイムアウト、またはレプリケーション中の送信元・送信先 CN の障害です。トラブルシューティングについては 可観測性 を参照してください。
warmup_level
- デフォルト:
NONE - 説明: キャッシュウォームアップのレベル。タブレットが初めて CN に配置されると、CN はこのレベルに従ってタブレットの最新バージョンを 1 回ウォームアップします。ウォームアップが完了するまで、レプリカはクエリから見えません。有効な値:
NONE(デフォルト): ウォームアップを行いません。新しいノードはコールドな状態で開始します。META: 最新のタブレットメタデータのみをウォームアップします。INDEX: 最新のタブレットメタデータに加えて、対応するデータファイルのフッター/インデックス部分をウォームアップします。ALL: 最新のタブレットメタデータに加えて、データファイル全体をウォームアップします (I/O 負荷が大きくなります)。
- ウォームアップのタイムアウトは、FE の動的設定項目
lake_compute_replica_warmup_timeout_secs(デフォルト:900秒) で設定します。このタイムアウトを過ぎると、ウォームアップが完了していなくても FE はレプリカを可視にします。 - ウォームアップのスレッド数は、CN の動的設定項目
tablet_warmup_max_threads(デフォルト:4) で設定します。
CN の障害によってウォームアップが中断された場合、FE はウォームアップが成功したものとみなし、ウォームアップのタイムアウト後にレプリカを可視にします。トラブルシューティングについては 可観測性 を参照してください。
ベストプラクティス
本番環境で推奨される構成は、レプリカ数 2、同期レプリケーション、インデックスレベルのウォームアップです。
コンソールで、Replica count を 2、Cache replication type を Synchronous、Cache warmup level を Index に設定します。
- 2 つのレプリカと
SYNCの組み合わせにより、1 台の CN がクラッシュしたりメモリ不足になったりしても、ウォームな 2 つ目のコピーが確保され、障害中もローカルキャッシュのヒット率をほぼ 100% に保てます。レプリカを増やすとローカルディスクのコストが増えますが、同期レプリケーションがロード性能に与える影響はごくわずかです。 INDEXウォームアップにより、スケールアウトやスケールインでタブレットが再配置されたときに、新しいノードがメタデータとデータファイルのフッターをすぐにウォームアップするため、スケーリングの前後でクエリレイテンシがほぼ一定に保たれます。ほとんどの場合、ALLは避けてください。すべてのデータファイルを読み込むため、大きな I/O 負荷がかかります。
これらの設定を組み合わせることで、共有データ構成のパフォーマンスの信頼性を、マルチレプリカのシェアードナッシング構成と同等の水準に引き上げることができます。
バージョンごとの提供状況
レプリカ数、キャッシュレプリケーションタイプ、ウォームアップレベルといった設定項目と、キャッシュレプリケーションおよびウォームアップの動作そのものは、v3.5 以降で利用できます。バージョンによって異なるのはこの部分ではありません。
異なるのはフェイルオーバー時のルーティングの信頼性です。信頼できるフェイルオーバーは、ノードの入れ替わり時にクエリをどのようにルーティングするかを決める、クエリプランナー、ノードの死活監視、キャッシュウォームアップに関する一連の改善に依存しています。
- クエリプランナーは、クエリをコールドなノードにルーティングする代わりに、単一レプリカのプランに切り替えます。
- ノードがシャットダウンまたはクラッシュすると、その死活状態がすぐにスケジューラーに報告され、そのノードのレプリカは選択されなくなります。
- 再起動後にノードが復帰すると、そのレプリカは再度ウォームアップされ、キャッシュの準備が整うまでクエリのルーティング対象から外されます。コールドな状態でクエリを処理することはありません。
これらの改善は v4.0 以降 (26.x 系を含む) に含まれていますが、3.5.x 系にはバックポートされていません。そのため、3.5.x ではノードの入れ替わり時にクエリがコールドなノードにルーティングされる可能性があります。これが、Compute Replica が 3.5.x では実験的機能、v4.0 以降ではベータ機能である理由です。フェイルオーバーで Compute Replica を利用する前に、クラスタがこれらの修正を含むバージョンで動作していることを確認してください。
可観測性
キャッシュレプリケーションとウォームアップのメトリクスは、共有データ用ダッシュボードと汎用の監視ダッシュボードで確認できます。
キャッシュレプリケーション
メトリクス:
file replicate total count/file replicate fail count: ファイルレプリケーションの総数と失敗数。active file being replicated: レプリケーションのために現在受信中のファイル。async file replication wait count/async file replication timeout count: キューの深さとタイムアウト数 (ASYNC の場合のみ)。file replication send/receive throughput: 送信/受信データ量の瞬間値。file replication send/receive latency (quantile / average): 送信/受信レイテンシの P99 と平均。
ログ: レプリケーション失敗の原因を特定するには、CN ログ CN.INFO でキーワード cache_replication_token を検索します。コンソールに表示されるのは FE の監査ログだけですが、CN の INFO と WARNING のログは information_schema.be_logs を通じて SQL で読み取れます。例: SELECT * FROM information_schema.be_logs WHERE LOG LIKE '%cache_replication_token%';。BYOC クラスタでは、SSH で CN ノードにサインインし、そこで CN.INFO を検索することもできます。
キャッシュウォームアップ
メトリクス:
Warm Up Success Count/Warm Up Fail Count: ウォームアップに成功したタブレット数と失敗したタブレット数。Warm Up Current Count: キュー内にある、またはウォームアップ中のタブレット数 (同時に処理される数はtablet_warmup_max_threadsで制限されます。デフォルトは4)。Warm Up Read Remote Per Minute: ウォームアップ中の 1 分あたりのリモート読み取り回数。Warm Up Latency: タブレットごとのウォームアップレイテンシの平均と P99。
ログ: ウォームアップ失敗の原因を特定するには、CN ログ CN.INFO でキーワード tablet_warmup_manager を検索します。コンソールに表示されるのは FE の監査ログだけですが、CN の INFO と WARNING のログは information_schema.be_logs を通じて SQL で読み取れます。例: SELECT * FROM information_schema.be_logs WHERE LOG LIKE '%tablet_warmup_manager%';。BYOC クラスタでは、SSH で CN ノードにサインインし、そこで CN.INFO を検索することもできます。